

Java programátor expert


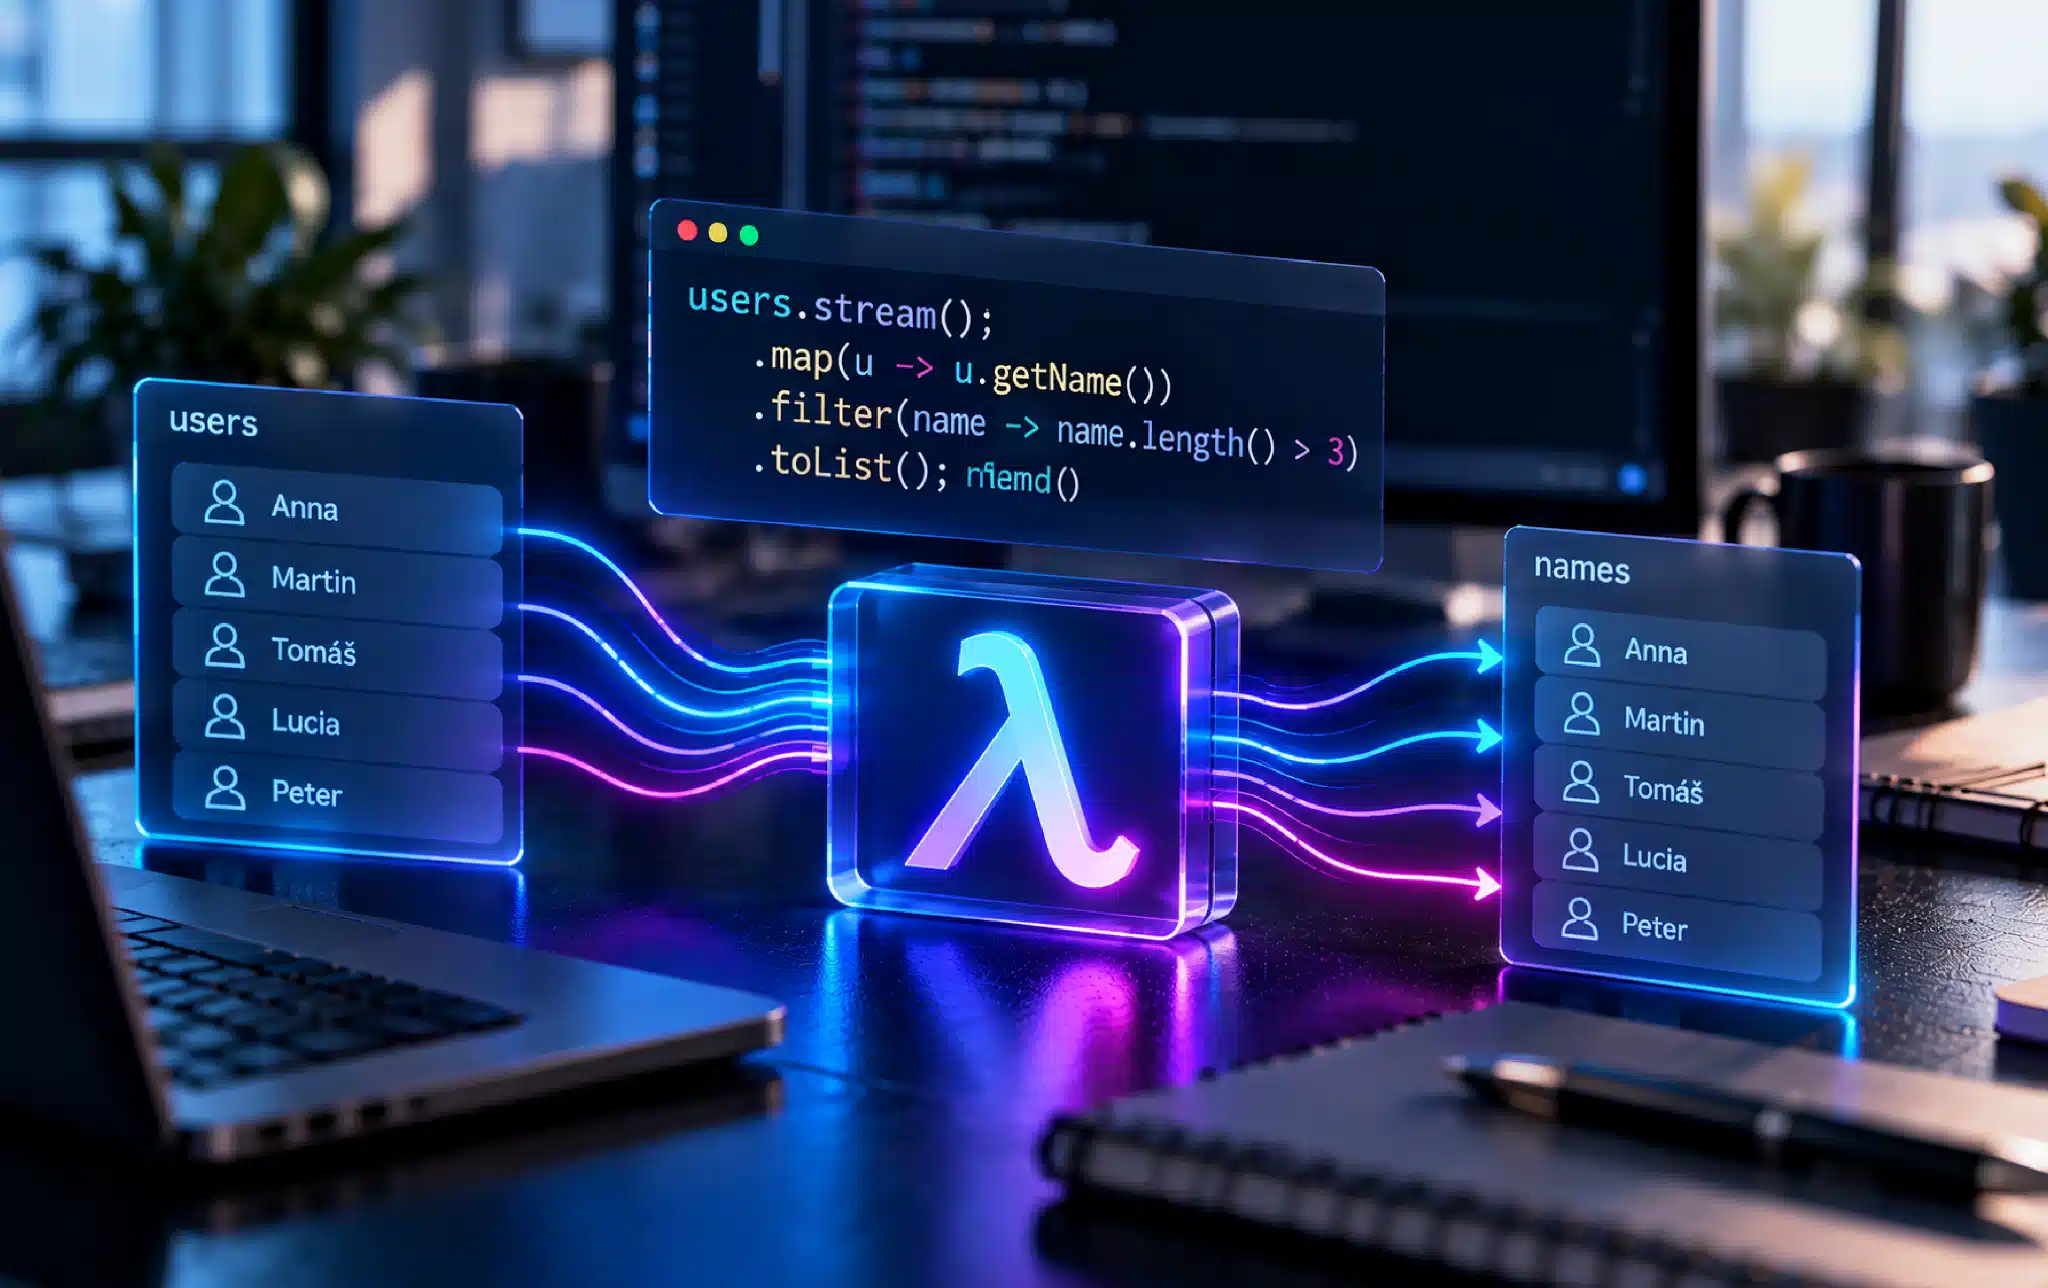
Java Stream API prináša do Javy deklaratívny spôsob práce s dátami: namiesto opisu jednotlivých krokov spracovania jednoducho povieš, aký výsledok chceš získať. Tento tutoriál ti na príkladoch kódu ukáže, ako stream vzniká, aké operácie ponúka a ako z neho získať výsledok.
V článku sa dozvieš:
Práve čítaš prvý článok zo série Java Stream API, ktorý sa venuje základom. Druhú časť s pokročilými technikami nájdeš v článku Pokročilé techniky Java Streamov.
Príchod Javy 8 v roku 2014 priniesol Java Stream API a s ním najväčšiu zmenu v jazyku od zavedenia generík v Jave 5. Dovtedy boli vývojári vedení k imperatívnemu spôsobu uvažovania, to znamená, že riešenie problému sa zapisovalo ako sled presných krokov, ktoré sa vykonávajú jeden po druhom, podobne ako ich spracúva samotný procesor.
Java Stream API tento prístup zásadne mení. Nejde len o skrátený zápis existujúcich konštrukcií ani o kozmetické vylepšenie jazyka. Predstavuje prechod k deklaratívnemu spracovaniu dát, pri ktorom sa sústreďuješ na výsledok, ktorý chceš dosiahnuť, a nie na detailný postup, akým má program k tomuto výsledku dospieť.
Predstavme si, že riešime bežnú úlohu: máme zoznam používateľov a potrebujeme získať mená všetkých aktívnych používateľov, zoradené v abecednom poradí.
Riešenie starým spôsobom by mohlo vyzerať nasledovne:
List<String> activeUserNames = new ArrayList<>();
for (User user : users) {
    if (user.isActive()) {
        activeUserNames.add(user.getName());
    }
}
Collections.sort(activeUserNames);
Na prvý pohľad ide o úplne korektný a funkčný kód. Pri podrobnejšom pohľade sa však objaví niekoľko nedostatkov:
Ekvivalentné riešenie moderným prístupom by sme prepísali takto:
List<String> activeUserNames = users.stream()
    .filter(User::isActive)
    .map(User::getName)
    .sorted()
    .collect(Collectors.toList());
Rozdiel je okamžite viditeľný. Tento kód sa číta takmer ako prirodzený opis problému:
„Vezmi používateľov, vyfiltruj aktívnych, transformuj ich na mená, zoraď a ulož do zoznamu.“
Jednotlivé kroky sú jasne oddelené, logika je prehľadná a výsledok je čitateľný aj bez detailnej znalosti implementačných mechanizmov.
Hlavným dôvodom vzniku Java Stream API nie je skrátenie kódu, ale zmena spôsobu uvažovania o spracovaní dát.
Imperatívny prístup (for cykly) – pozornosť sa sústreďuje na riadenie toku programu. Vývojár presne určuje, ako má byť úloha vykonaná: kedy iterovať, kedy kontrolovať podmienku a kam ukladať výsledky. Ide o detailné riadenie každého kroku spracovania.
Deklaratívny prístup (streamy) – dôraz sa kladie na výsledok, nie na postup. Vývojár popisuje, čo chce dosiahnuť, zatiaľ čo detaily iterácie, optimalizácie a poradia spracovania sú ponechané na implementácii Java Stream API.
Tento rozdiel tvorí základ všetkého, čo v ďalších kapitolách o Java Stream API uvidíme.
V imperatívnom príklade je potrebné vytvoriť pomocnú premennú activeUserNames, ktorú následne v priebehu cyklu opakovane meníme. Takýto prístup môže prirodzene viesť k vedľajším, neželaným efektom.
Streamy podporujú funkcionálny štýl programovania:
Výsledkom je čistejší kód, ktorý sa jednoduchšie udržiava a je výrazne bezpečnejší pri paralelnom spracovaní.
Ide o koncept, ktorý začiatočníci často prehliadajú, no práve on má zásadný vplyv na výkon streamov.
Pri zápise users.stream().filter(User::isActive); nespracuje program ani jeden prvok. Stream si iba zostavuje akýsi spracovateľský plán pre postupnosť operácií, ktoré sa môžu vykonať. Skutočné spracovanie dát sa spustí až pri zavolaní terminálnej operácie, napríklad collect, count, findFirst alebo forEach.
Možno sa teraz pýtaš, prečo je to dôležité? Z dôvodu efektivity. Ak máš napríklad milión používateľov, ale hľadáš len prvého aktívneho:
Optional<User> firstActive = users.stream()
    .filter(User::isActive)
    .findFirst();
Stream spracuje iba minimum prvkov potrebných na nájdenie výsledku a následne okamžite skončí. Vďaka tzv. short-circuiting správaniu nemusí nikdy prejsť celú kolekciu. Naopak, nevhodne navrhnutý imperatívny kód by mohol zbytočne iterovať cez všetky prvky.
Teraz už vieš, prečo Java Stream API nepredstavuje len modernejší zápis cyklov, ale úplne nový spôsob práce s dátami. Ďalším krokom je pochopenie anatómie streamu: zdroj, intermediárne operácie a terminálne operácie, aby bolo jasné, čo presne sa deje medzi vstupom a výsledkom.
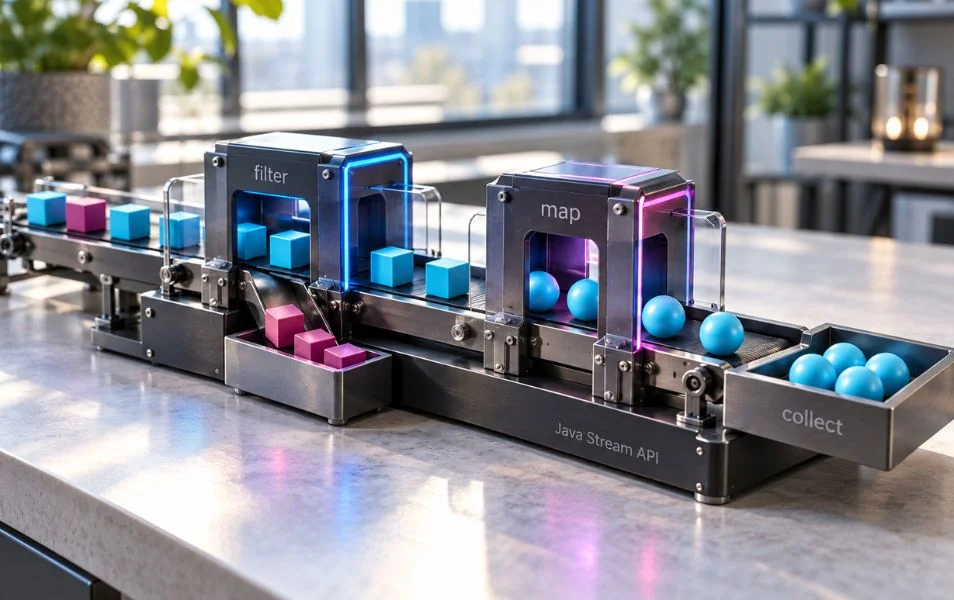
Ak by sme mali Java Stream API prirovnať k niečomu z reálneho sveta, veľmi výstižná je analógia výrobnej linky. Dáta vstupujú na jednom konci, postupne prechádzajú sériou spracovateľských krokov a na konci vzniká výsledok.
Aby bolo možné streamy používať efektívne a predvídateľne, je nevyhnutné pochopiť tri základné fázy tejto spracovateľskej pipeline:
Tieto fázy si ukážeme na jednoduchom, no výstižnom príklade:
List<String> names = Arrays.asList("Anna", "Bill", "Charlie", "Diana");
long count = names.stream()            // 1. Source
    .filter(s -> s.startsWith("A"))    // 2. Intermediate operation
    .map(String::toUpperCase)          // 2. Intermediate operation
    .count();                          // 3. Terminal operation
Všetko sa začína dátami. Zásadná myšlienka, ktorú si treba uvedomiť, je, že stream nie je dátová štruktúra. Stream dáta neukladá, nekopíruje ani nevlastní. Slúži len ako abstrakcia, ktorá umožňuje dáta zo zdroja postupne získavať a spracúvať v momente, keď sú skutočne potrebné.
Zdrojom streamu môže byť napríklad:
Oddelenie dát od spôsobu ich spracovania patrí medzi základné dizajnové princípy Java Stream API.
Intermediárne operácie predstavujú jednotlivé spracovateľské kroky v pipeline. Patria sem napríklad filter, map, sorted, distinct a mnoho ďalších.
Majú dve spoločné a kľúčové vlastnosti: vždy vracajú nový stream a nespúšťajú spracovanie dát. Vďaka tomu je možné operácie reťaziť (method chaining) a vytvárať prehľadné a plynulé spracovateľské reťazce.
Z hľadiska výkonu rozlišujeme dva typy intermediárnych operácií.
Takéto operácie môžu obmedzovať výkon, najmä pri spracovaní veľkých dátových množín.
Terminálna operácia predstavuje moment, v ktorom sa spracovanie skutočne vykoná. Dovtedy je stream len pasívnym popisom toho, čo by sa malo stať.
Terminálna operácia:
Medzi najčastejšie terminálne operácie patria collect, count, reduce, findFirst a forEach.
Po vykonaní terminálnej operácie je stream považovaný za uzavretý. Akýkoľvek pokus o jeho opätovné použitie skončí výnimkou IllegalStateException.
Častou mylnou predstavou je, že jednotlivé operácie v streame sa vykonávajú po celých kolekciách, najprv filter, potom map, následne sorted a podobne. V skutočnosti streamy fungujú vertikálne, nie vo vrstvách.
Najprv sa vezme prvý prvok („Anna“), ktorý prejde cez filter. Ak vyhovuje podmienke, okamžite pokračuje do map a následne do terminálnej operácie. Až potom sa spracúva ďalší prvok („Bill“).
Tento mechanizmus sa nazýva loop fusion a prináša dve zásadné optimalizácie:
Stream sa teda skladá zo zdroja dát, prechádza sériou intermediárnych operácií a končí terminálnou operáciou, ktorá až spustí samotné spracovanie. Práve to robí jeho pipeline takou efektívnou. Spôsobov, ako taký stream vytvoriť, je pritom oveľa viac než jediné volanie .stream() na kolekcii, a niektoré z nich bývajú prekvapivo výkonnejšie aj flexibilnejšie.
Väčšina vývojárov sa so Java Stream API prvýkrát stretne pri volaní list.stream(). Ide však len o základný a najčastejší prípad. Java 8 a novšie verzie poskytujú viacero spôsobov, ako vytvárať streamy z rôznych typov dátových zdrojov, a niektoré z nich sú výrazne výkonnejšie a flexibilnejšie, než sa na prvý pohľad zdá. Ak chceš Java Stream API používať efektívne, je dôležité všetky tieto možnosti poznať.
Najbežnejším zdrojom streamu sú kolekcie. Každá trieda implementujúca rozhranie Collection (List, Set, Queue) poskytuje metódu stream():
List<String> letters = List.of("A", "B", "C");
Stream<String> stream = letters.stream();
Pozor na mapy
Častou chybou začiatočníkov je pokus o použitie map.stream(). Trieda Map neimplementuje rozhranie Collection, a preto túto metódu nemá. Namiesto toho je potrebné vytvoriť stream z jednej z jej kolekčných projekcií:
// Stream of keys
scores.keySet().stream();

// Stream of values
scores.values().stream();

// Stream of key-value pairs (most common)
scores.entrySet().stream();
V praxi sa najčastejšie pracuje so streamom nad entrySet(), pretože poskytuje prístup ku kľúčom aj hodnotám zároveň.
Pri práci s poľami (najmä v staršom alebo existujúcom kóde) sa na vytváranie streamov používa pomocná trieda Arrays:
String[] languages = {"Java", "Python", "C#"};
Stream<String> stream = Arrays.stream(languages);
Pri primitívnych poliach je tento prístup obzvlášť dôležitý:
int[] numbers = {1, 2, 3};
IntStream intStream = Arrays.stream(numbers);
Namiesto Stream<Integer> sa použije IntStream, čím sa eliminuje zbytočný autoboxing a dosiahne sa lepší výkon.
V niektorých situáciách nie je potrebná kolekcia, cieľom je len rýchlo spracovať niekoľko objektov. Typickým príkladom sú testy alebo ukážkový kód:
Stream<String> stream = Stream.of("Spring", "Hibernate", "JPA");Metóda Stream.of(…) interne deleguje na Arrays.stream(…). Rozdiel spočíva najmä v čitateľnosti a expresivite zápisu.
Jednou z najsilnejších, no často prehliadaných vlastností Java Stream API je práca so vstupno-výstupnými zdrojmi. Metóda Files.lines(Path) vracia stream reťazcov, kde každý prvok reprezentuje jeden riadok súboru.
Rozdiel oproti tradičným prístupom je zásadný:
Pri veľkých súboroch (stovky MB alebo GB) má tento prístup výrazný vplyv na spotrebu pamäte a výkon:
try (Stream<String> lines = Files.lines(Paths.get("server.log"))) {
    lines.filter(line -> line.contains("ERROR"))
         .forEach(System.out::println);
} catch (IOException e) {
    // handle exception
}Streamy vytvorené z I/O zdrojov implementujú rozhranie AutoCloseable. Vždy ich používaj v bloku try-with-resources, inak hrozí únik systémových zdrojov, napríklad nezatvorené súbory.
Streamy nemusia mať konečný počet prvkov. Java Stream API umožňuje generovať hodnoty za behu, čím vznikajú potenciálne nekonečné dátové toky. Takýto stream je potrebné obmedziť, napríklad operáciou limit(), inak terminálna operácia nikdy neskončí.
Vhodné vtedy, keď nasledujúci prvok závisí od predchádzajúceho, napríklad pri číselných postupnostiach alebo sekvenciách dátumov:
// Generates: 0, 2, 4, 6, 8
Stream.iterate(0, n -> n + 2)
    .limit(5)
.forEach(System.out::println);Používa sa na generovanie nezávislých hodnôt, napríklad náhodných čísel alebo nových inštancií objektov:
// Generates 5 random UUIDs
Stream.generate(UUID::randomUUID)
    .limit(5)
    .forEach(System.out::println);
Java Stream API nie je obmedzené len na kolekcie. Možno ho efektívne využiť na spracovanie polí, mapových štruktúr, veľkých súborov aj nekonečných dátových tokov. V nasledujúcej kapitole sa dostaneme k samotnému jadru práce so streamami – filtrovaniu a transformácii dát. Ukážeme si, kedy použiť flatMap a prečo patrí medzi najčastejšie nepochopené koncepty v Java Stream API.
Ak by sme si stream predstavili ako výrobnú linku, práve v tejto fáze prebieha samotné spracovanie dát. Surové vstupy sa filtrujú, transformujú a preklápajú do podoby, ktorá je vhodná pre ďalšie spracovanie alebo výslednú agregáciu.
Všetky operácie, ktoré si v tejto kapitole ukážeme, majú dve spoločné vlastnosti:
Základnou operáciou je metóda filter(Predicate<T>). Prijíma podmienku a do ďalšej fázy pipeline pustí len tie prvky, pre ktoré podmienka vráti hodnotu true:
// Classic filter: keep only even numbers
stream.filter(n -> n % 2 == 0);Od Javy 9 pribudli dve metódy, ktoré sú mimoriadne užitočné pri zoradených streamoch.
Predstav si zoradený zoznam cien: [10, 20, 30, 40, 50, 60]. Cieľom je získať všetky hodnoty menšie ako 40: stream.filter(n -> n < 40);. Táto verzia prejde všetky prvky, aj keď už narazí na hodnoty 50 a 60.
Naproti tomu verzia s metódou takeWhile prvky spracúva len dovtedy, kým podmienka platí. Pri jej prvom porušení okamžite ukončí spracovanie celého streamu: stream.takeWhile(n -> n < 40);
Pri veľkých dátových množinách môže ísť o zásadný výkonnostný rozdiel.
Metóda dropWhile funguje presne opačne – zahadzuje prvky, kým podmienka platí, zvyšok streamu pustí ďalej bez ďalšieho testovania: stream.dropWhile(n -> n >= 40);
Metóda map(Function<T, R>) slúži na transformáciu jedného objektu na iný. Pre každý vstupný prvok vznikne presne jeden výstupný prvok. Počet prvkov v streame sa nemení, mení sa len ich typ alebo reprezentácia:
List<String> emails = users.stream()
    .map(User::getEmail)          // User -> String
    .map(String::toLowerCase)     // String -> String
    .collect(Collectors.toList());
Metódu map používaj vždy vtedy, keď má transformácia jednoznačný výsledok pre každý vstupný prvok.
Metóda flatMap patrí medzi najčastejšie nepochopené operácie v Java Stream API.
Základné pravidlo je jednoduché:
Máme zoznam vývojárov (Developer) a každý ovláda viacero jazykov (List<String> languages). Chceme získať zoznam všetkých jazykov, ktoré tvoj tím ovláda.
Stream<List<String>> result = developers.stream()
    .map(Developer::getLanguages);
Výsledkom je Stream<List<String>> – stream zoznamov! Výstup môže byť napr. [[„Java“, „Go“], [„Python“], [„Java“, „C++“]], takýto tvar je vo väčšine prípadov nevhodný na ďalšie spracovanie.
Aplikovanie flatMap na stream robí dve veci naraz: aplikuje mapovaciu funkciu a sploští vnorené štruktúry do jedného plynulého streamu:
List<String> allLanguages = developers.stream()
    .flatMap(dev -> dev.getLanguages().stream()) // must return a Stream
    .distinct()
    .collect(Collectors.toList());
Výsledok je [„Java“, „Go“, „Python“, „C++“].
Streamy sú často dlhé reťazce operácií. Čo ak to na konci vráti zlý výsledok? Ako zistíme, čo sa stalo po filter a pred map? Nemôžeme jednoducho do stredu zápisu vložiť System.out.println, pretože to by rozbilo syntax.
Na tento účel slúži peek(Consumer<T>). Umožňuje nakuknúť do streamu bez toho, aby ho modifikoval:
List<Integer> result = Stream.of(1, 2, 3, 4)
    .filter(n -> n % 2 == 0)
    .peek(n -> System.out.println("After filter: " + n)) // Debug log
    .map(n -> n * n)
    .peek(n -> System.out.println("After map: " + n))    // Debug log
.collect(Collectors.toList());Metóda peek by sa mala používať len na ladenie. Nikdy ju nepoužívaj na zmenu stavu objektov, pretože pri paralelných streamoch môže byť správanie nepredvídateľné a pri niektorých JVM optimalizáciách môže byť peek dokonca preskočený, ak Java zistí, že neovplyvňuje výsledok.
Dáta máme vyfiltrované a transformované. Sú pripravené v pamäti, ale stále sme ich nespracovali do konečnej podoby. Ďalším krokom sú terminálne operácie, ktorými celý tento proces spustíme a získame výsledok.
Doteraz sme len definovali plán. Vytvorili sme akési potrubie (stream), nastavili filtre a transformácie, ale voda ním ešte netečie. Terminálna operácia je ten moment, keď otočíš kohútikom. Bez terminálnej operácie sa stream nespustí. Akonáhle ju zavoláš, celý stream sa spracuje a následne sa považuje za spotrebovaný a nedá sa použiť znova.
Nepotrebuješ vždy spracovať všetky dáta. Stačí ti odpoveď typu áno / nie. Presne na to slúžia tzv. skratové (short-circuiting) operácie, podobne ako operátory && alebo || v podmienkach. Akonáhle poznajú výsledok, okamžite končia.
boolean hasAdmin = users.stream()
    .anyMatch(User::isAdmin); // Stops as soon as the first admin is found
Tieto operácie sú extrémne efektívne, najmä pri veľkých datasetoch.
Obe metódy vracajú Optional<T>, pretože stream môže byť prázdny, napríklad ak filter zahodí všetky prvky.
V sekvenčnom streame je rozdiel medzi nimi minimálny, zvyčajne sa vráti prvý prvok. V paralelnom streame je findAny() výrazne rýchlejší, pretože nemusí synchronizovať vlákna, aby zistil, ktorý prvok je prvý. Ak ti nezáleží na poradí, preferuj findAny(), dáva JVM viac priestoru na optimalizáciu.
Tieto operácie zredukujú celý stream na jednu hodnotu:
Pri min a max opäť dostávaš Optional, pretože prázdny stream nemá minimum ani maximum:
Optional<User> oldestUser = users.stream()
    .max(Comparator.comparingInt(User::getAge));

oldestUser.ifPresent(u ->
System.out.println("Oldest user: " + u.getName()));Zavolanie metódy forEach(Consumer) je terminálna operácia, ktorá spracuje každý prvok streamu. Práve tu však vývojári najčastejšie porušujú princípy Java Stream API.
Zlaté pravidlo hovorí o tom, že forEach používaj iba pri operáciách, ktoré nemenia výsledok výpočtu. Napríklad za vhodné použitie sa považuje výpis do konzoly, logovanie alebo uloženie objektu do databázy.
List<String> result = new ArrayList<>();
stream.forEach(s -> result.add(s)); // DO NOT DO THIS!
// Use collect(Collectors.toList()) instead
Pri paralelných streamoch toto správanie vedie k chybám, napríklad výnimke ConcurrentModificationException, alebo strate dát.
Pri paralelnom spracovaní forEach negarantuje poradie vykonávania (vhodné pre rýchlosť). Ak potrebuješ zachovať poradie aj pri paralelnom streame, napríklad pri výpise do konzoly, použi forEachOrdered. Spomalí to však proces, pretože vlákna sa musia synchronizovať.
Matkou všetkých agregácií je metóda reduce. Prijíma počiatočnú hodnotu a funkciu, ktorá spája dva prvky do jedného. Pomocou nej vieš implementovať sumu, súčin alebo zreťazenie reťazcov:
int sum = numbers.stream()
    .reduce(0, (a, b) -> a + b);

// or even better:
// .reduce(0, Integer::sum)
Pomocou reduce vieš implementovať sumu, súčin, zreťazenie textov alebo vlastné agregácie.
V praxi však častejšie siahneš po Collectors, ktoré sú čitateľnejšie a optimalizované pre bežné scenáre, ako zbieranie do kolekcií, zoskupovanie či sumarizácia.
Metóda map transformuje každý prvok na presne jeden nový prvok, takže počet prvkov v streame ostáva rovnaký. Metóda flatMap naproti tomu spája viacero hodnôt z jedného prvku, napríklad zoznamy, do jedného plochého streamu – využiješ ju najmä pri práci s vnorenými štruktúrami.
Nie. Po zavolaní terminálnej operácie sa stream považuje za spotrebovaný a akýkoľvek ďalší pokus o jeho použitie skončí výnimkou IllegalStateException. Ak potrebuješ rovnaké dáta spracovať viackrát, musíš z pôvodného zdroja vytvoriť nový stream.
Stream sa oplatí vtedy, keď chceš dáta filtrovať, transformovať alebo agregovať deklaratívnym spôsobom a kód má ostať čitateľný a bezstavový. Pri jednoduchej iterácii bez transformácie, alebo keď potrebuješ meniť premenné mimo cyklu, môže byť naopak prehľadnejší klasický for cyklus.
Gratulujeme, už ovládaš základy Java Stream API. Hoci sme sa dotkli pomerne veľkého množstva nových pojmov, v skutočnosti už vieš všetko podstatné, čo Java vývojár potrebuje na každodennú prácu so streamami:
Tieto znalosti tvoria pevný základ, na ktorom stojí moderné používanie Java Stream API. Odporúčam ti ich najskôr prakticky precvičiť, napríklad tak, že v existujúcich projektoch nahradíš vybrané imperatívne cykly streamami a porovnáš si čitateľnosť výsledného kódu.
V ďalšom článku Java Stream API – pokročilé techniky nadviažeme priamo na základné poznatky o Java Stream API. Pozrieme sa na výkonnostné aspekty, paralelné streamy, časté chyby a anti-patterny vrátane refaktoringu reálneho kódu.
Súvisiace články